Main transformer model structure with unified memory layout. More...
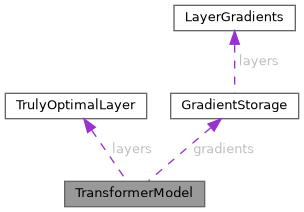
Collaboration diagram for TransformerModel:
Public Attributes | |
| char | magic [8] |
| Magic string "BUMPWGT2" for file validation. | |
| uint32_t | version |
| Weight file format version. | |
| uint32_t | model_type |
| Model architecture: 0=GPT2, 1=LLAMA, etc. | |
| int | num_layers |
| Number of transformer layers (e.g., 12 for GPT-2) | |
| int | vocab_size |
| Vocabulary size (e.g., 50257 for GPT-2) | |
| int | embed_dim |
| Embedding dimension (e.g., 768 for GPT-2 small) | |
| int | context_window |
| Maximum sequence length (e.g., 1024) | |
| size_t | aligned_embed_dim |
| embed_dim rounded up to 64-byte alignment (in floats) | |
| size_t | aligned_head_dim |
| head_dim rounded up to 64-byte alignment (in floats) | |
| size_t | aligned_attn_context_window |
| context_window padded to prevent false sharing | |
| int | num_cores |
| Number of CPU cores to use (OpenMP threads) | |
| int | tokens_per_core |
| Tokens assigned per core: context_window / num_cores. | |
| int | num_attention_heads |
| Number of attention heads (e.g., 12 for GPT-2) | |
| int | head_dim |
| Dimension per head: embed_dim / num_attention_heads. | |
| float * | memory_base |
| Base pointer to single contiguous memory block. | |
| size_t | total_floats |
| Total size of memory block in float elements. | |
| size_t | layer_stride |
| Byte offset between consecutive layer memory blocks. | |
| size_t | token_emb_offset |
| Token embedding table [vocab_size × aligned_embed_dim]. | |
| size_t | pos_emb_offset |
| Positional embedding table [context_window × aligned_embed_dim]. | |
| size_t | embedded_input_offset |
| Combined token+pos embeddings [context_window × aligned_embed_dim]. | |
| size_t | layers_start_offset |
| Start of first transformer layer memory. | |
| TrulyOptimalLayer * | layers |
| Array of per-layer offset structures. | |
| size_t | final_ln_weight_offset |
| Final LayerNorm gamma [aligned_embed_dim]. | |
| size_t | final_ln_bias_offset |
| Final LayerNorm beta [aligned_embed_dim]. | |
| size_t | final_ln_mean_offset |
| Final LayerNorm mean [context_window]. | |
| size_t | final_ln_rstd_offset |
| Final LayerNorm rstd [context_window]. | |
| size_t | final_output_offset |
| Final normalized output [context_window × aligned_embed_dim]. | |
| size_t | lm_head_weight_offset |
| Language model head (weight-tied to token_emb_offset) | |
| size_t | logits_offset |
| Output logits [context_window × vocab_size]. | |
| GradientStorage | gradients |
| Gradient and activation cache memory (training only) | |
| bool | training_enabled |
| Whether gradient storage is allocated. | |
| float | learning_rate |
| SGD learning rate for weight updates. | |
| int | lr_warmup_steps |
| Number of steps to linearly warm up the LR. | |
| float | lr_warmup_init |
| Starting LR for warmup (defaults to 0 when unset) | |
| float | grad_clip |
| Clip gradients to +/- this value (0 disables) | |
| size_t | training_cache_samples |
| Number of training windows cached inside arena. | |
| int | active_tokens |
| Number of tokens populated in current forward pass. | |
| TaskType | task_type |
| Active training/inference task. | |
| OptimizerType | optimizer |
| Selected optimizer. | |
| uint64_t | optimizer_step |
| Number of optimization steps taken. | |
| float | adam_beta1 |
| float | adam_beta2 |
| float | adam_eps |
| float | weight_decay |
| bool | ema_enabled |
| float | ema_decay |
| bool | optimizer_state_initialized |
| bool | seq_cls_enabled |
| int | seq_cls_num_classes |
| int | seq_cls_pooling |
| 0=final,1=cls,2=mean | |
| size_t | seq_cls_weight_offset |
| size_t | seq_cls_bias_offset |
| bool | kv_cache_enabled |
| Whether KV cache regions are allocated/used. | |
| int | kv_cache_capacity |
| Maximum tokens stored in cache. | |
| int | kv_cache_tokens |
| Number of valid tokens currently cached. | |
| long * | training_data_buffer |
| Pointer to in-memory buffer for the entire training dataset. | |
| long | num_training_tokens |
| Total number of tokens in the preloaded dataset. | |
| uint8_t | checksum [32] |
| SHA256 checksum of weight file. | |
| uint8_t | reserved [32] |
| Reserved for future extensions. | |
Detailed Description
Main transformer model structure with unified memory layout.
This structure encapsulates the entire transformer model state in a single contiguous memory block. All tensors (weights, activations, gradients) are accessed via byte offsets from memory_base.
Design Philosophy:
- Single malloc/mmap for entire model (eliminates fragmentation)
- Offset-based addressing (enables memory-mapped weight files)
- Cache-line aligned tensors (64-byte boundaries)
- Hugepage-backed allocation (2MB pages reduce TLB pressure)
Memory Layout:
┌─────────────────────────────────────────────────────────────┐
│ Token Embeddings [vocab_size × aligned_embed_dim] │ ← Shared with lm_head
├─────────────────────────────────────────────────────────────┤
│ Positional Embeddings [context_window × aligned_embed_dim] │
├─────────────────────────────────────────────────────────────┤
│ Layer 0 (weights + activations) │
│ Layer 1 (weights + activations) │
│ ... │
│ Layer N (weights + activations) │
├─────────────────────────────────────────────────────────────┤
│ Final LayerNorm │
├─────────────────────────────────────────────────────────────┤
│ Logits [context_window × vocab_size] │
├─────────────────────────────────────────────────────────────┤
│ Gradient Storage (if training_enabled) │
└─────────────────────────────────────────────────────────────┘
size_t aligned_embed_dim
embed_dim rounded up to 64-byte alignment (in floats)
Definition main.c:525
bool training_enabled
Whether gradient storage is allocated.
Definition main.c:573
int vocab_size
Vocabulary size (e.g., 50257 for GPT-2)
Definition main.c:521
int context_window
Maximum sequence length (e.g., 1024)
Definition main.c:523
Parallelism Model:
- Token-level parallelism: Context window divided among
num_cores - Each core processes
tokens_per_coretokens independently - Head-level parallelism: Attention heads processed independently
Alignment Guarantees:
aligned_embed_dim: Padded to 64-byte boundary for AVX-512aligned_head_dim: Padded to 64-byte boundary (prevents false sharing)aligned_attn_context_window: Padded attention score matrix rows
- See also
- layout_transformer Memory layout computation
- bump Offset-based allocation helper
The documentation for this struct was generated from the following file: